提取文本的结果有错字或没有任何内容
ZunShot 使用 Windows 内置的 OCR 引擎。识别结果取决于已安装的识别语言和图片质量。
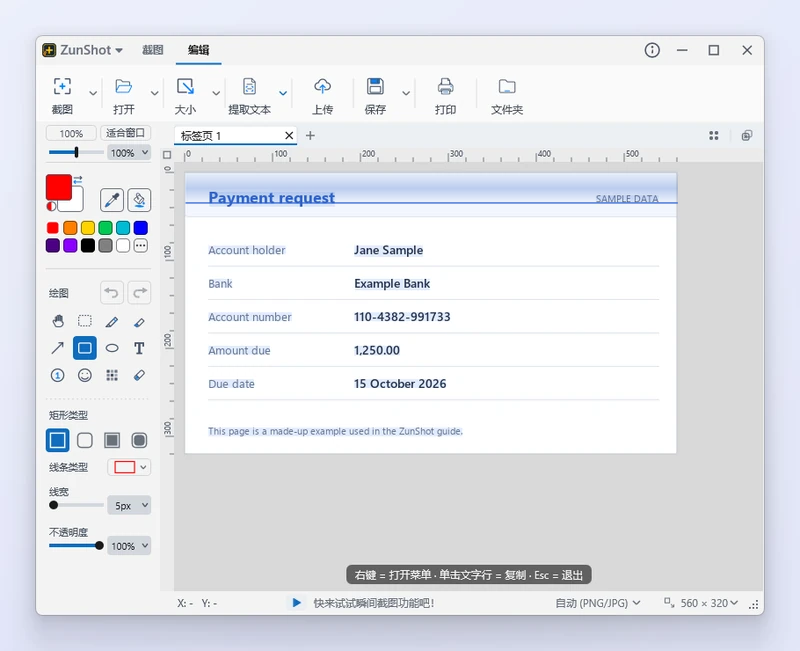
出现乱码
识别语言与文字不一致。请在提取文本面板中选择正确的语言。如果列表中没有该语言,请安装:设置 > 语言 > 安装 OCR 语言…。
已安装语言,但 OCR 仍然失败
Windows 只有在安装了该语言的基本输入法功能后才会注册 OCR 引擎,仅安装显示语言是不够的。请打开 Windows 的“设置” > “时间和语言” > “语言和区域”,选择该语言,然后添加“基本输入法”。
没有识别到任何内容
- 放大截图,使文字高度至少达到约 20 像素,然后重新提取。
- 裁剪掉文字周围的照片和图标。
- 压缩严重或经过艺术化处理的文字可能无法识别。
更多内容请参阅使用指南:提取文本(OCR)。
快速解答
- 为什么 OCR 识别出来的是乱码?
- 所选语言与图片中的文字不一致。请选择或安装正确的 Windows OCR 语言。
- 进行 OCR 时会上传我的图片吗?
- 不会。识别由 Windows OCR 引擎在本机上完成。